Za pomocą tego bloku można odczytać wartości z tekstu. Odpowiedni wzorzec wyszukiwania jest zdefiniowany we właściwościach.
Spis treści
Wejścia↑
| Skrót | Krótki opis | Opis |
|---|---|---|
| T | Text Input | Tekst polecenia. |
Wyjścia↑
| Skrót | Krótki opis | Opis | Zakres wartości |
|---|---|---|---|
| Lv | Last extracted value | Ostatnia uzyskana wartość | ∞ |
Właściwości↑
| Krótki opis | Opis | Wartość standardowa |
|---|---|---|
| Rozpoznawanie poleceń | Oznaczenia wartości: v - wartość, 1 - oznaczenie pierwszego bajtu wartości (2, 3, ...), h - wartość szesnastkowa Znaki do poruszania się po tekście, pomija: . = dowolny znak, w = dowolne słowo, # = dowolna liczba, d = cyfra 0-9, m = Znak A-Z/a-z/0-9, a = Znak A-Z/a-z, s12 = pomiń 12 znaków, iTexti = przejdź za 'Text' Znaki specjalne: x = liczba szesnastkowa (np. 0x09), \ = ukośnik, t = Tab (0x09), b = spacja (0x02) lub Tab (0x09), r = powrót (0x0d), n = nowa linijka (0x0a) | - |
| Interpretacja wartości ze znakiem | Jeśli zaznaczone, podczas rozpoznawania poleceń wartości 1234 będą używane ze znakiem (Signed Integer) | - |
Przykład programowania↑
Rozpoznawanie poleceń może być używane do nawigacji w tekście lub tekście źródłowym oraz do pobierania wartości.
Znaki używane do wyodrębnienia wartości:
v = wartość liczbowa
1 = wartość bajtu interpretowanego jako 1. bajt wyjścia (2, 3, ...)
- Jeśli odebrane dane są interpretowane jako szesnastkowe (np. „x0A”), otrzymywany jest dziesiętny odpowiednik (10 w tym przykładzie). Ta metoda działa również w przypadku wielu bajtów szesnastkowych (np. „x0Ax0B”). Po połączeniu te bajty tworzą 32-bitową liczbę całkowitą 0x0A0B, a 21 zwraca 2571 w systemie dziesiętnym. Ta sama wartość, po wyodrębnieniu za pomocą 1, daje 10 w zapisie dziesiętnym.
- Jeśli odebrane dane są interpretowane jako tekst, każdy bajt reprezentuje znak ASCII. Na przykład „Loxone” odpowiada znakowi Line Feed o kodzie ASCII 76.
- Dane mogą być używane jako podpisane liczby całkowite, biorąc pod uwagę prawidłową kolejność bajtów i stosując rozszerzenie znaku, jeśli to konieczne.
h = wartość interpretowana jako liczba szesnastkowa
- Jeśli odebrane dane są ciągiem szesnastkowym reprezentowanym jako tekst (np. „0A”), można je przekonwertować na ich dziesiętny odpowiednik (10 w tym przykładzie).
- Ta metoda działa również w przypadku wielu danych szesnastkowych (np. „0A0B”). Po przekonwertowaniu z szesnastkowego na dziesiętny, „0A0B” odpowiada 2571.
Znaki do poruszania się po tekście:
. = dowolny znak
w = dowolne słowo
# = dowolna liczba
d = cyfry 0-9
m = znak A-Z/a-z/0-9
a = znak A-Z/a-z
s12 = pomiń 12 znaków
- Na przykład, s12 pomija 12 znaków, gdy odebrane dane są ciągiem tekstowym.
- Jeśli odebrane dane są ciągiem szesnastkowym reprezentowanym przez sekwencje specjalne (np. xFExFFx00x12xA0xB0xC1xD2xE3xF4x11x16x17), to s12 pominie 12 bajtów szesnastkowych. W tym przypadku przeskoczy za x16, efektywnie pomijając łącznie 48 znaków tekstowych (ponieważ każdy bajt szesnastkowy jest reprezentowany przez cztery znaki tekstowe).
iTexti = skok za „Text”
Znaki specjalne:
x = liczba szesnastkowa (np. 0x09)
= Slash
t = Tab (0x09)
b = spacja (0x02) lub tabulator (0x09)
⧵r = Return (0x0d)
⧵n = nowa linia (0x0a)
W poniższym przykładzie chcemy wyodrębnić bieżącą cenę gazu ziemnego:
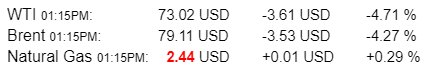
Ponieważ tekst „Natural Gas” jest stały, możemy przejść do tej pozycji w tekście. Aby wyodrębnić bieżącą cenę, musimy pominąć wskazanie czasu. Istnieje kilka opcji, aby to zrobić:
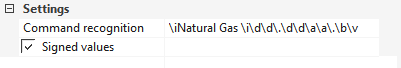
Wariant 1 da
Z d pojedyncze cyfry i z a pojedyncze znaki mogą zostać pominięte:
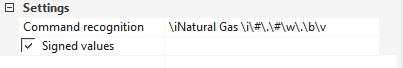
Wariant 2 #w
Za pomocą # można pominąć liczbę, a za pomocą w dowolne słowo:
Wariant 3 s8
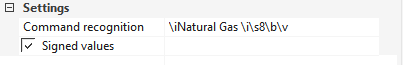
Ponieważ w tym przykładzie czas zawsze będzie miał taką samą liczbę cyfr i znaków, można je pominąć za pomocą s8: